AI 写了 90% 代码后,Anthropic 怎么把 code review 做不崩
原文:How the Claude Code team does code review 作者:Addy Osmani, Morgan Westlee Lunt, Qing Wang(Anthropic Claude Code 团队) 来源:claude.dev 官方博客,发布于 2026 年 10 月 15 日
 【关键词:#ClaudeCode #代码审查 #AI编程】
原文开篇连着问三个问题:每天 agent 产出这么多量,该怎么 review?还有人在读代码吗?真出事了谁来兜?
这问题问得很准,因为 Claude Code 团队自己就是那个极端案例——Claude 写了约 90% 的 Claude Code 代码。我把原文和配套的工程博客、官方文档全过了一遍,最有价值的部分整理在这里。
01|先看场景:AI 是主要作者时,review 为什么崩
三个数字摆出来,问题的量级就清楚了:
- Claude 自己写 Claude Code 约 90% 的代码
- Anthropic 的 monorepo 每天落地的变更数,从 5 月的约 2,500 涨到 9 月的 30,000+(Claude Code 在独立仓库,不在这个 monorepo 里,但同样在承压)
- 6 月到 9 月,Claude Code 自己仓库的合并 PR 翻了一倍多,而需要 revert 的比例下降超过 40%
九成代码由 AI 写、每天三万次变更落地,人力逐行 review 在这个量级下不是"困难",是"不可能"。
他们定的目标很具体:让 Claude Code 各仓库(CLI、桌面与 Web 应用、移动端)的大多数 PR,在最多一个真人在环(且这个人可以是作者本人)的情况下合入,且不增加 revert 或线上事故率。
这里有个容易被忽略的细节:他们衡量"人的时间"时,同时算审的时间和修的时间。只压缩审的时间、改的时间却涨上来,等于没省。
方法论上他们做了一次替换。原来问的是"有没有人读过这段代码",现在问的是"这个改动可能出什么问题,该由哪道检查——自动的还是人——来兜"。前者是个不精确的代理指标,后者才指向动作。
原文那句话我很喜欢:"We didn't remove review." 他们没有取消 review,只是把"读"这件事大部分交给了机器,并且把"出错要能快速撤销"当成一等公民来投资。review 的形态从"路的尽头设一道关卡"变成"像拼写检查一样,写的时候就在跑"。
02|六层检查:把 review 从一道关卡拆成多层防线
原文的架构图标题是 "Six layers of checks, with rollback under them",回滚兜在最底下。我按阶段重排了一遍:
| 阶段 | 检查 | 抓什么 |
|---|---|---|
| PR 之前 | 工作先被验证 | Claude 跑测试、build、linter;另一个 agent 在全新上下文里复审 diff |
| 每个 PR | Required CI | lint、类型、跨平台测试、build、packaging,红了直接挡合并 |
| 每个 PR | Claude code review | 多个 agent 并行找 bug,验证者对每条 finding 投票,存活者按严重度排序 |
| 每个 PR | Security review | 独立一遍,安全漏洞;bug review 或 security review 的 finding 没关掉,PR 合不进去 |
| 每个 PR | Risk-based approval | 分类器定级:0 个、1 个还是 2 个真人;部分路径永远要人 |
| 合并时 | Merge queue | 把检查在最新 main 上重跑一遍,两个各自通过的 PR 合起来不会破 main |
| 上线后 | flag → 内部先用 → 分级发布 → 回滚 | latest channel 先、stable 跟随;flag 不用部署就能关 |
原图的标注是:"Most of the path is automated; a person's attention goes where the risk is." 路径大部分是自动的,人的注意力去风险所在的地方。
PR 之前那一层最值得抄。 他们给 Claude 一件"能跑的东西"——测试、build、或者一张用来和设计稿对比的截图,然后要求它交出运行结果,而不是说"我搞定了"。Boris Cherny(Claude Code 的作者)估过这件事能让最终结果好 2 到 3 倍,他还补了一句:"每个领域的验证方式不一样,可能就是跑一条 bash 命令、跑一遍测试套件,或者在浏览器和手机模拟器里试。"
还有一个反直觉的做法:自动 reviewer 反复标同一个问题时,源头修掉它——加进 skill、加一条 lint 规则,或者更新说明文件,而不是在每个 PR 里手工纠正。
至于怎么让 reviewer 知道"这个项目算对":
CLAUDE.md写清项目是什么:技术栈、约定、目标和非目标。每次 review 都会加载它,所以大仓库里要写得短,需要别的细节就往外指。reviewer 还会挑出破坏约定、或让某行说明过期的改动。REVIEW.md由 code owner 写,告诉 reviewer 在他那块代码里什么重要。他们会单独检查 reviewer 是否真的遵守了它。写得好的REVIEW.md很短:说明这个仓库里"失败"长什么样(文档是"它撒谎",配置是"它路由错了"),给 nit 设上限,列出要跳过的路径,并且要求给出文件和行号作为证据,而不是从名字猜;还要求一个以计数开头的总结,没东西可改就直说没有。
Claude review 这一层读的是整个仓库加 PR 自述的意图,问三个问题:这个改动解决了它的问题吗?合不合系统?会不会弄坏别的什么。修 bug 时它会去找根因。结果按严重度排成 Important / Nit / Pre-existing——Pre-existing 单独标出来,是为了让 PR 之前就存在的问题不看起来像作者的责任。
数据方面:推出研究预览版时,内部 PR 里拿到实质 review 评论的比例从 16% 涨到 54%。另外,超过 1,000 行的 PR 大多能被挑出 finding,小 PR 大多干净返回。Code Review 现在在 Team 和 Enterprise 方案上正式可用,/code-review 在本地跑的是轻量版。管理员可以给每个仓库设 Quick、Standard 或 Deep,Deep 适合"漏一个 bug 的代价高于多花这点审查时间"的地方。
有个边界他们写得很死:产品的定位是发 finding,不是发 approval——"批准一个 PR 仍然是一个人的判断"。自动审查能放行低风险改动,但填不了需要人那一格。
03|review 收敛:截断 agent 互啄的无限循环
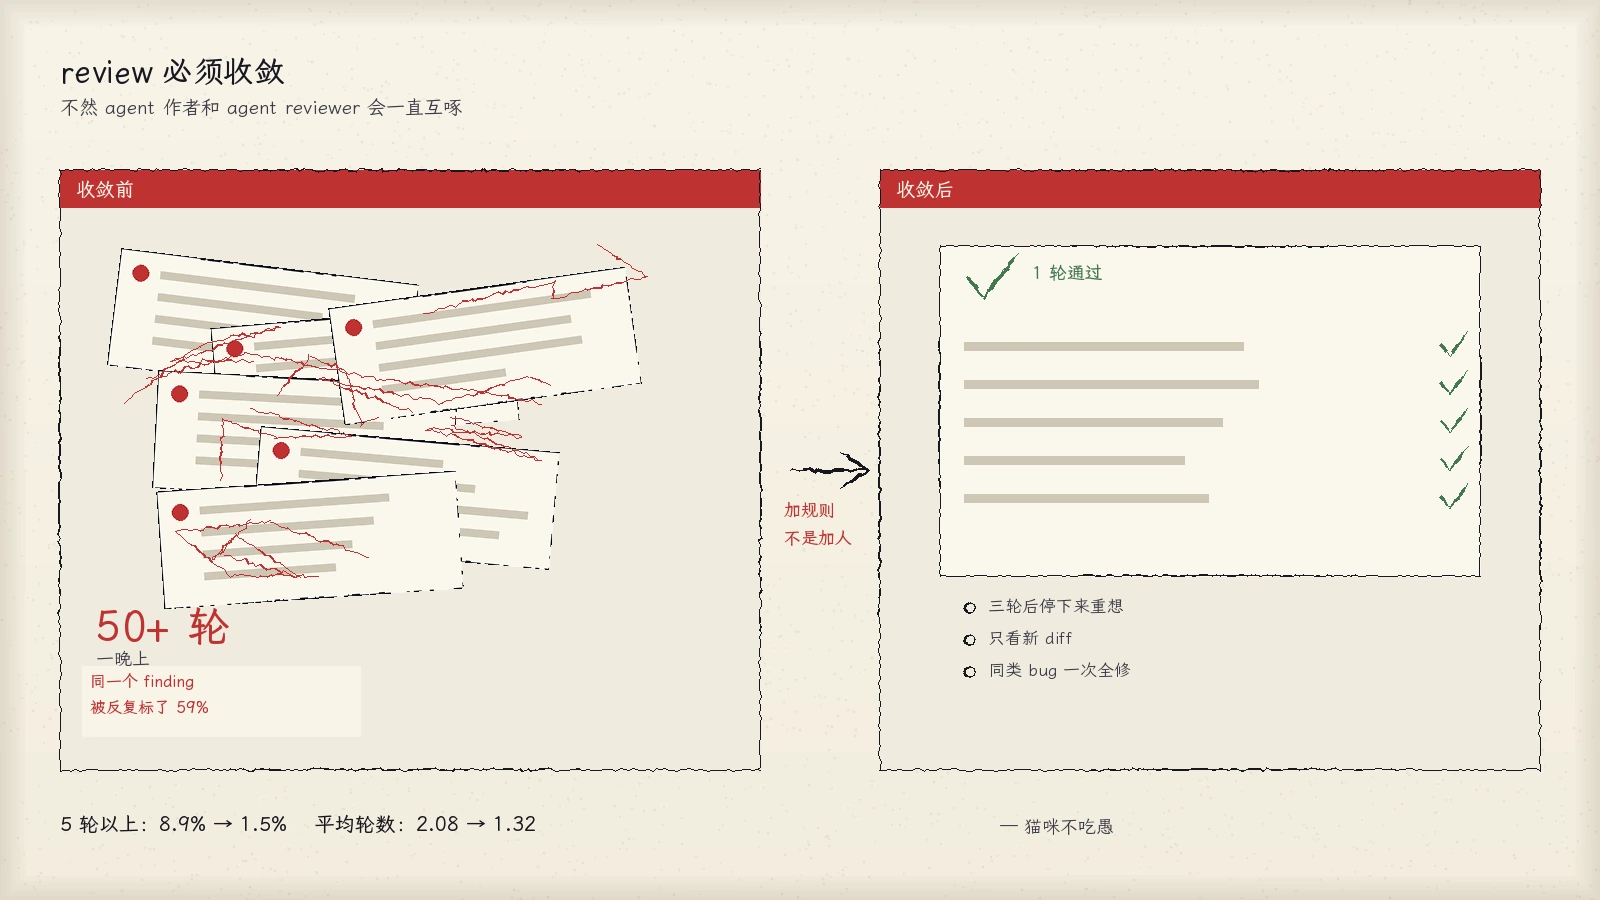
这是我读全文最想拿出来讲的一段。
先看噪音为什么在 agent 场景下更贵。原文说得直白:人几秒钟就能挥手 dismiss 一个 nit,但 agent 会去修它,于是多一个 commit、多一轮 review。所以他们不看"抓了多少 bug",而是看人对每条评论的实际反应:修了、说它错了、说这是有意为之、或者觉得无所谓。另外还会把 reviewer 跑在已知干净的 PR 上,数它有多少次会报出"如果照做会引发有害改动"的结论。
优先级的官方表述就一句:先抓真 bug,再压 review 轮数。
代价有多夸张?他们有个 CLI PR 一晚上跑过 50 多轮 review 和修改才被作者叫停。git blame 显示,reviewer 反复标出的内容里约 59% 是第一轮就标过、但 agent 没动的代码——reviewer 很少在找新 bug,只是在每一轮多找出几个旧问题。
他们自己承认有一半责任:"我们已经习惯默认跑好几轮,因为每一轮都觉得能捞点新东西。高风险改动这样值得,但不是每个 PR 都该这样。"
四条收敛规则:
- 三轮之后,reviewer 让作者停下、退一步重新审视方案
- 前几轮之后只 re-review 新 diff
- 标出 bug 类别,让作者一次修完所有同类,不是改一行
- 已发过的 finding 不重复
效果(Claude Code 仓库内部 PR):
| 指标 | 改动前 | 改动后 |
|---|---|---|
| 1 轮通过 | 65% | 78% |
| 5 轮以上 | 8.9% | 1.5% |
| 平均 review 轮数 | 2.08 | 1.32 |
把事故变成评测集是另一件有创意的事。团队把过去出过事故的 PR 连同修复和 revert 收集起来,让熟悉那段代码的工程师逐个确认 bug 是真的、在哪。reviewer 每天对着这组用例跑一遍,每次改 prompt、工具或模型都要重新打分,分数降就放弃。
还有一层反向检查:在已知干净的 PR 上跑 reviewer,看它会不会报出"照做就有害"的结论。只看召回是不够的。
关于"慢下来",团队里有个同事的说法我记下了:放慢确实能降低错误率,但主要是因为你做的所有事情都变少了。他们更想走的是"更快发现、更快修好"这条。
04|人留在哪 5 件事上
原文的说法是:把一个资深工程师从深度工作里拉出来抓一个低级错误,代价远高于让机器自动 review。所以人该被放在这些位置:
- 方向、口味和范围。有个团队宣称自己的 review 瓶颈解决了,但对来自团队外的改动依然保留人审——总得有人问"这事该不该做"
- 高风险代码,比如 billing、自动更新、CI workflow
- 会传染的架构决策(一个模式会被别人抄的那种)
- 看证据。测试输出、跑过的命令和它的返回、截图、reviewer 的 findings。如果你说不出"哪些检查会漏掉",就要一份真的 review,而不是快速批准
- 为结果负责。不管谁敲的键盘,出了事签字的人负责
最后一条有个技术细节:agent 写的 PR 上,指挥 agent 的那个人算一个必需 reviewer,和他自己敲代码一样。而且如果之后落进来的是系统没法背书的提交——agent 自己的 push,或者有人手动 resolve 掉的合并——审批得重新给一次。
第二件被机器接管的事是代码库理解的传播。原文说得很坦率:"We don't have a formal process for this." 团队里没人脑子里装着 Claude Code 的完整模型,他们也不觉得需要有人装着。想了解某块代码,就让 Claude 针对那一块写份 explainer——几分钟,反映的是代码当下的真实状态。有人更进一步,让 Claude 造一个小工件把那段代码可视化,按自己习惯的学习方式定制。
原话:"一行文案的改动几乎不教你任何东西;一份你接下来要改的模块 explainer 能教你很多。"
05|可直接搬走的流程清单
PR 之前:
- 在简短的
CLAUDE.md里列出 agent 能跑的检查 - 跑
/code-review和/security-review,或在新上下文里用 subagent 复审 - 加
REVIEW.md,把"这个仓库里失败长什么样"写清楚,限制 nit 数量,列出要跳过的路径
每个 PR:
- 必走 CI,PR 模板加 "Testing" / "Risk" / "How to revert"
- 先在一个仓库接入 AI reviewer(Code Review for Claude Code 或 Claude Code GitHub Action),调几周再铺开
- 接入自动化安全审查,要求所有 review 线程 resolve 才能合并
- review 力度匹配风险:常规改动快速过,漏一个 bug 代价大的地方上 Deep
- 限制 review 轮数,前几轮之后只 re-review 新 diff
审批:
- 把风险层级写下来,按变更而不是按作者设定,先严后松,用证据放松
- 宽松审批路径只给可信作者
- 用 CODEOWNERS + branch protection 确保 auth、billing、CI、release workflow、安装器总要人
- 永远不让机器人的 approval 顶替必需的真人审批;新提交进来就把旧审批作废
合并之后:
- merge queue、feature flag、内部先用、分级发布、一键回滚
- 把事故和 revert 变成 eval 集,prompt / 工具 / 模型一变就重新打分
- 度量人的时间,把 revert 和事故率当 guardrail
最后一条他们也说得很实在:"我们还没有在指标恶化时自动收紧审批的熔断器"——团队里的工程师想先看到这个,才敢让更多代码走向零真人合入。也就是说,这条边界由信任度决定,不是技术决定。
读完整篇,我的几个判断:
风险分级按"变更"而不是"作者资历",这是消除"按人分配工作量"的关键。一个分类器读 PR 自动定级,低风险全自动——但"永远需要人"的那批路径得写死在配置里。
reviewer 必须有自己的评测集,否则会随时间悄悄劣化。事故即用例,每天跑,改一次 prompt 就重打一次分。这是把线上事故反向用作离线回归集。
噪音度量比"抓 bug 数"更重要。光看召回会越调越吹毛求疵,必须看人对每条评论的实际反应,还要在已知干净的 PR 上反向测一遍。
review 必须收敛。加轮数上限、加 diff-only re-review、加同类 bug 批量修。agent 作者配 agent reviewer 可以无限互啄,必须人为截断。
PR 模板里硬塞"怎么测、怎么回滚"——agent 能填,但真人签字。
新行为的发布管道是 flag → 内部全员用一周 → latest channel → stable channel。这比任何审查都更靠后,但它是最后一道兜底。
你团队现在用 AI 写代码的比例大概是多少?review 流程里有没有给 AI 留出专门的位置,还是仍然全靠人盯人?