AGENTS.md 写对一次 ≈ 一次模型升级:60k 仓库总结的 5 段结构、6 个模式、5 类反模式
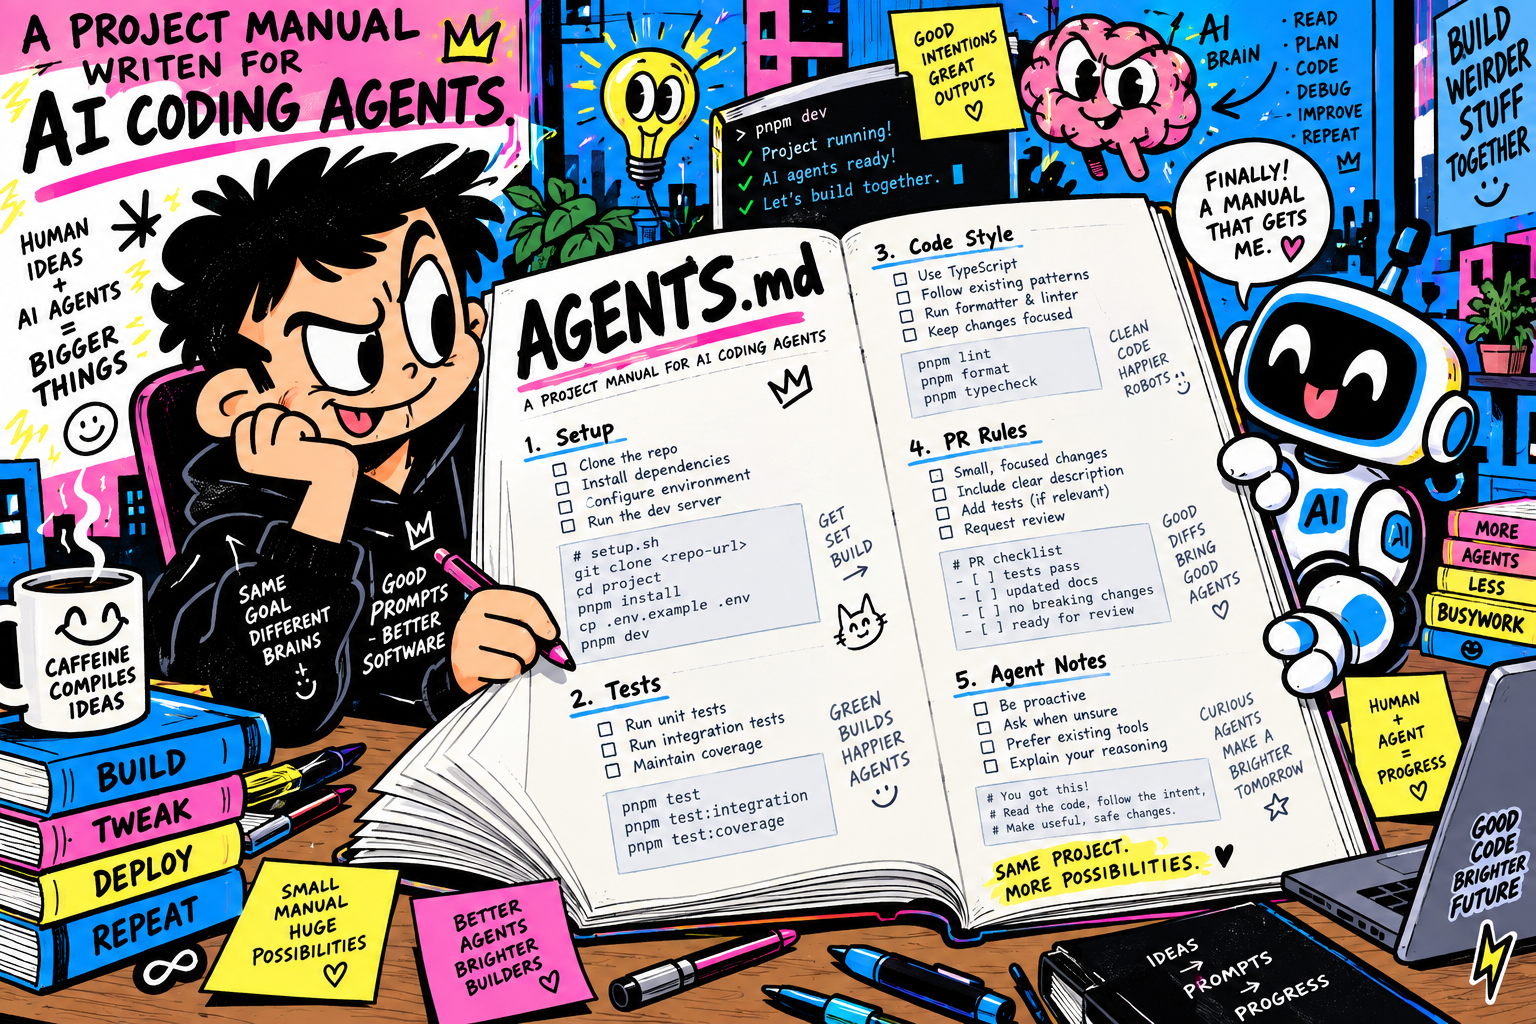
一句话定位:README 写给人看,AGENTS.md 写给 AI Agent 看。
AGENTS.md 不是文档,是 Prompt。你不是在写文档,是在做上下文工程。 —— Augment Code 工程博客
【关键词:#AGENTSmd #AI编程 #上下文工程】
01|和模型强弱到底是什么关系:三种打架的结论
"我用了 Claude Opus 还需要写 AGENTS.md 吗?"——最近这一两个月,被问到这一句的次数,比过去一年加起来还多。
网上数据打架,我整理出三种主流结论。
我的判断一:好的 AGENTS.md ≈ 一次模型升级。Vercel 的 Next.js Evals 这套基准是所有数据里跑得最干净的——没有 AGENTS.md 的时候,Claude Sonnet 4.6 通过率只有 67%;加一份好的 AGENTS.md 之后直接到 100%。GPT 5.3 Codex 同样从 86% 拉到 100%。最反直觉的一行:——一份好文档的杠杆,比一次模型升级还大。
判断二:弱模型受益更大,但强模型也吃这套。The Prompt Shelf 综合 60k+ 仓库数据后画了一条更细的线——弱模型缺乏世界知识,必须靠显式上下文才能在同一个代码库上工作;前沿模型能自己推断大部分约定,但对非显而易见的项目约定(部署步骤、内部 API、仓库特有坑)仍然需要 AGENTS.md。边际价值不同,但没有哪个模型可以裸奔。
判断三:差的 AGENTS.md 比没有还糟。Augment Code 的实测 有点打脸:同一份 AGENTS.md,任务 A 提升了 25%,任务 B 反倒掉了 30%。——规则一旦自相矛盾,模型就开始犯傻。
还有一份反方证据值得我提一下。Tom Kennes 引用的 SWE-bench 研究给出了一个反直觉的发现:LLM 自己生成的 AGENTS.md,任务成功率反而掉了,成本还涨了 20%;人手写的才有轻微提升。强模型 ≠ 能写出更好的 AGENTS.md——这点让我自己也想了一下。研究的局限在 Python 仓库和较旧模型,但提醒很清晰——别让 AI 替你写给 AI 的说明书。
我的综合判断是——。弱模型受益更明显(提升 50%+),前沿模型也有 14-29% 的提升。我越来越觉得:决定上限的不是模型本身,是上下文的清晰度和可执行性。(提升 50%+),强模型也有 14-29% 的提升。决定上限的不是模型本身,是上下文的清晰度和可执行性。
02|一份合格的 AGENTS.md 应该长什么样
经过一年多的社区收敛,大家写 AGENTS.md 的章节顺序基本稳定了。顺序不是细节——Codex/Copilot 对靠前的章节会加权,所以最重要的东西要往前放。
第一段是 Project Overview,2-3 句话说明项目做什么、架构、关键事实。这是大多数仓库漏掉的第一段。
第二段是 Tech Stack + 固定版本号。Go 1.22、zap v1.27、pgx v5——版本号一定要写死,不要写"较新版本"。模型会按它训练数据里的旧约定走,比如给你写 io/ioutil(这包 Go 1.16 就 deprecated 了)。版本号是防呆,不是装饰。
第三段是 Commands,写可复制粘贴的精确命令。build/test/lint/typecheck 一条不能少,最好给单文件变体和"不要跑"的标记。这里有个数字值得记一下:用编号步骤写部署流程,缺失配置文件的比例从 40% 降到 10%。
第四段是 Code Style。函数不超过 20 行、禁止 any、错误以 Result 返回——每条规则都附上 Reason。我自己的经验是:模型听"为什么不这么做"比听"应该怎么做"更买账——理由一写,它就老实多了。
第五段是 Testing Instructions。怎么跑、覆盖率预期、单测试聚焦命令、Mock 策略。不要为了"让测试通过"而删测试——这条单独提一下,因为太容易踩。
第六段是 Architecture / Repo Map。关键目录、模块边界、入口点、共享逻辑位置。这是模型最容易"自由发挥"的地方,不写明它就按自己的理解走——经常跑到奇怪的地方去。
第七段是 PR & Commit Guidelines。分支命名、commit 格式、提交前检查。这一段短,但少了它 Agent 提 PR 会乱来。
第八段是 Security Considerations。密钥、敏感文件、不要 log 的字段。这条默认就有,但写得越具体,AI 越不会在测试代码里硬塞假 key。
第九段是 Boundaries,收益最高的一类。Augment 的数据显示这是边际价值最大的一个,分三档:
- Allowed:src/、test/
- Ask first:migrations/(schema 变更需 review)
- Never touch:vendor/、.gen.ts、.env、node_modules/、dist/、lock 文件
边界一定要带理由。"不要手改 go.sum,因为 go mod tidy 会覆盖"——理由一写,模型就老实多了;光说"不要碰",它反而更想去碰。
6 个真的写得动的写法:
- 渐进式展开——核心文件 100-150 行 + 引用文件;超过 150 行效果反转
- 流程化描述——编号步骤部署/测试
- 决策表——解决代码库歧义(React Query vs Zustand)
- 真实代码片段——3-10 行模板
- 领域特定规则——具体的"不许做"清单
- 8KB 压缩规则——Vercel 推荐把 40KB 文档索引压缩到 8KB
Vercel 还做了一组对比,结果更反直觉:被动上下文 > 主动 Skills 调用。AI 有"Skills"按需加载的选择权时,;把同样信息直接塞进 AGENTS.md 反而到 。我的总结——让模型不犯错的上下文环境,比 AI 是否更聪明更重要。
03|五类致命反模式:写得差比没有更糟
反模式一:空文件 / 套话文件。模型学到 0。"写完美代码""保持高质量""遵循最佳实践"——不可执行,等于没写。"We prefer zap"——没用,要写"使用 zap v1.27 配 sugared logger,不要 log.Println"。
反模式二:长篇小说。把 40KB 的架构文档全塞进 AGENTS.md。模型注意力被稀释,关键规则淹没在背景里。Vercel 推荐 8KB、Augment 推 100-150 行。超过这个量级要拆出去。
反模式三:重复 README。README 给人的,AGENTS.md 给 agent 的。重复浪费 token,还会让模型优先信错的那一份。
反模式四:让 AI 写 AGENTS.md。SWE-bench 那条结论最反直觉——LLM 自动生成的 AGENTS.md,任务成功率反而降低,成本还涨了 20%。强模型写不出好的 AGENTS.md,甚至写给自己的也不行——它的脑子里没有"人需要什么"的视角。
反模式五:不放具体命令。"We prefer zap" 是反面教材。要写到能复制粘贴的颗粒度——"使用 zap v1.27,不要 log.Println;commit 前跑 go vet ./... && go test ./... && golangci-lint run"。
我自己写这份写作仓库的 AGENTS.md,第一版也犯过空文件病——写了三段"应该有结构""应该注意风格",没一条是 agent 能直接拿来用的。后来把"导语段末加关键词标签,最多 3 个"换成具体规则,立刻见效。
04|维护节奏:四个触发点胜过一个计划
AGENTS.md 是活的文档,不是写完就归档。我从社区经验里抽出四个值得固定下来的触发点。
触发点 1:AI 犯错就加一条。改 AGENTS.md 最值钱的时机。比如我抓到你(哪个 AI)编造了"我使用过"——立刻在 AGENTS.md 加一条"AI 不得自行编造第一人称经历"。每抓一次错,AGENTS.md 就多一道具体的护栏。
触发点 2:平台规则变化时。Go 出了新版本、zap 升了 major、CI 换工具——AGENTS.md 跟着调。否则模型会按训练数据里的旧约定走,老问题就回来了。
触发点 3:作者风格稳定时。把"反 AI 腔"的具体反例沉淀进文件,比列十条原则有效。"AI 不得使用 X、Y、Z 等空强调词"比"避免空话"可执行十倍,因为前者是禁令、后者是口号。
触发点 4:每季度做一次反向 checklist。拿 §12 那种清单精神反过来检查 AGENTS.md 自己:哪条失效了、哪条重复了、哪条没人读、哪条反而让 AI 更糟。无效的删掉、可合并的合并——别心疼。
最重要的:不要整篇重写。ICLR 2024 有研究指出,AI 协作写作会拉高不同作者之间的相似度。AGENTS.md 应该局部、可解释地演进——加一条比改一段更安全,整篇重写会丢掉你自己的"词汇指纹"。
写在最后|AGENTS.md 是一份"自我说明书"
写到这里回头看,AGENTS.md 的本质其实是把作者对自己项目的判断写下来。它不是写给"未来的 AI",是写给三个月后忘记细节的自己。
我们这个仓库不是软件项目,但 AGENTS.md 同样适用——只是承载的内容从代码约定变成了写作约定(红线、风格、版式、来源)。只要项目里有"AI 经常做错的隐性约定",AGENTS.md 就有价值——我们这个写作仓库就是活例子。
回到开头那个问题:和模型强弱到底是什么关系?
我的回答还是不变——AGENTS.md 不是"模型越强越不需要",而是"无论模型强弱都必要;写得差比没有更糟;人类手写 > LLM 自动生成;上下文工程的杠杆,大于一次模型升级"。
一份好的 AGENTS.md 对任务的提升可以等于一次模型升级。一份差的 AGENTS.md 比没有更糟——这条我反复验证过、你可以信。
作者:猫咪不吃愚(科技从业者 / 程序员 / 运动爱好者) 写于 2026 年 9 月
本文基于公开资料与多个开源社区(Augment Code、Vercel Next.js Evals、The Prompt Shelf、agents.md 官方仓库等)的研究整理;所有数据点均按可追溯链接标注;文中观点、判断与适用边界为作者本人立场。