OpenAI 把 Agents API 全部开放了——这是 AI 调度时代的第一声发令枪,我决定这么用
【关键词:#OpenAI Agents #AI 调度 #指数级生产力】
最近 OpenAI 把全新的 Agents API 公测版放出来了——只用一次 API 调用,就能在云端启动一个直接能上生产环境的 AI 智能体。消息刚出来那会儿我正在改一个 bug,看完发布会回放之后,那个 bug 我突然不太想改了——因为这件事比改任何一段代码都更值得我停下来想清楚。我不是被惊艳到了,我是被提醒到了:这件事如果只是当新闻看,那就白看了。
我想先说说我看到的真正信号。
这一波更新里最值钱的,不是 "Agents" 这个词,是它背后那整套「基础设施」。OpenAI 这次一口气放出来的是:长上下文管理、工具调用路由、子智能体协调、代码沙箱、文件读写、状态持久化、checkpoint 回滚——这一整套原本只在 Codex 内部和 ChatGPT 企业版里流转的东西,被原封不动地搬到了普通开发者面前。它等于正式宣布了一件事:造一个能稳定跑几天几夜的生产级智能体,从今天起不再是工程活,而是产品活。
对开发者来说,这个变化不是「又一波 AI 升级」,是底层假设换了——智能体的"长任务、异步、持久化"从 hack 变成了 first-class。这件事如果只是当新闻看,那 6 个月后你回头看,会发现自己错过了这一波最大的「复利」窗口期。
一、OpenAI 这次到底放出了什么,为什么我说它值钱
我反复看了三遍官方博客,重点不是"agent 能干什么",是"什么样的事情,从今天起不再需要你自己造轮子"。
第一层:长期上下文管理。一个 agent 跑几天几夜,最难的不是它能不能思考,是它能不能在几百万 token 里准确找回自己之前放下的那个细节。以前这件事要么靠你自己做摘要、要么靠模型自己挣扎、要么干脆任务跑到一半崩了重来。现在基础设施层把这个事接走了,开发者第一次不用再为「长任务的记忆」发愁。
第二层:工具调用 + 子智能体调度。一个 agent 不是孤岛,它要调用工具、要拆子任务、要让多个子 agent 协作完成一件事。这个能力以前每个团队都在自己造——造出来的水平参差不齐,bug 多到让人怀疑人生。现在 OpenAI 把 Codex 内部跑了一年多的那一套原样开放,等于定了一个事实标准。你不需要自己发明调度协议,按它的方式接入就行。
第三层:沙箱 + 持久化。一个能跑代码、能读写文件、能保存中间结果的智能体,没有安全沙箱就是定时炸弹。这次更新把这层基建也包进去了,等于告诉所有开发者:"你放心让 agent 写代码、跑脚本、写文件,出问题算我的"。
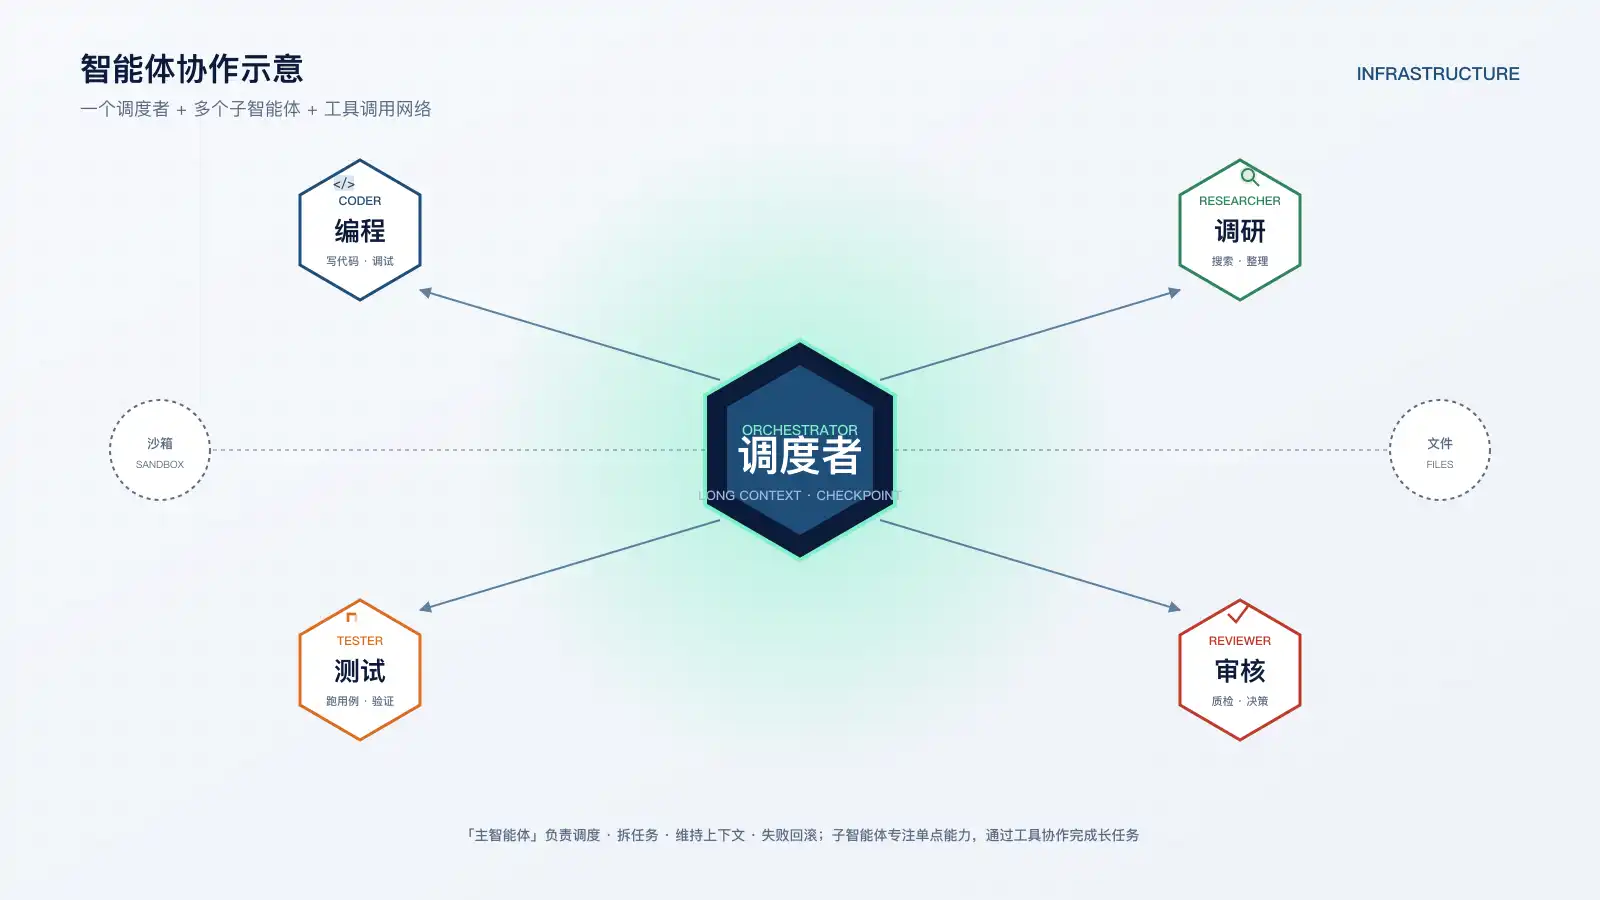
把这三件事拼起来看,它不是一次产品升级,是一次能力边界的扩张——AI 智能体第一次具备了「可以长期、可以生产、可以协作」这三个属性的统一。
一个能记、能干、能存、能恢复的智能体——以前这是一支小型 AI 创业公司一整年的活儿;现在是一次 API 调用。这就是「基础设施下沉」的真正含义:把造飞机的工程能力,交给一张机票。
二、为什么我说这次是「指数级」的机会,不只是一波升级
很多人听完这条新闻只会说"哦,OpenAI 又升级了"。但我想用我自己这周的算账说明——这是一次乘数效应,不是一次加法。
先看 OpenAI 这次放的是什么级别的东西。
我们做一下类比。过去十年这种级别的「基础设施下沉」,我数得出来的有三次:
| 时间 | 平台 | 下沉的能力 | 之后发生了什么 |
|---|---|---|---|
| 2008 | AWS EC2 | "做服务器" | 创业公司不再自建机房,全世界多出来一整代 SaaS |
| 2008 | iOS App Store | "做移动应用分发" | 一个人能做出月活过亿的产品 |
| 2023 | ChatGPT API | "接入大模型对话能力" | 一年冒出几千个 AI 原生应用 |
| 2026 | OpenAI Agents API | "做生产级智能体" | ? |
你会发现一个规律——每一次基础设施下沉,都不会让现有玩家更舒服,它会让下一波新玩家以十倍以上的密度入场。
再看它为什么是「指数级」而不是「线性」。
我自己的账是这样算的:
原来:1 个工程师 × 8 小时工作 × 5 天 = 40 小时产出
现在:1 个工程师 × 8 小时指挥 + N 个 agent × 24 小时 × 7 天 = 一周完成过去一个季度的事
关键的乘数不是「agent 比人快」,而是「agent 不下班、不摸鱼、可以并行」。一个会指挥的工程师,配合一群不停工的 agent,理论产能上限是原来的 5–10 倍——而且这只是开始。
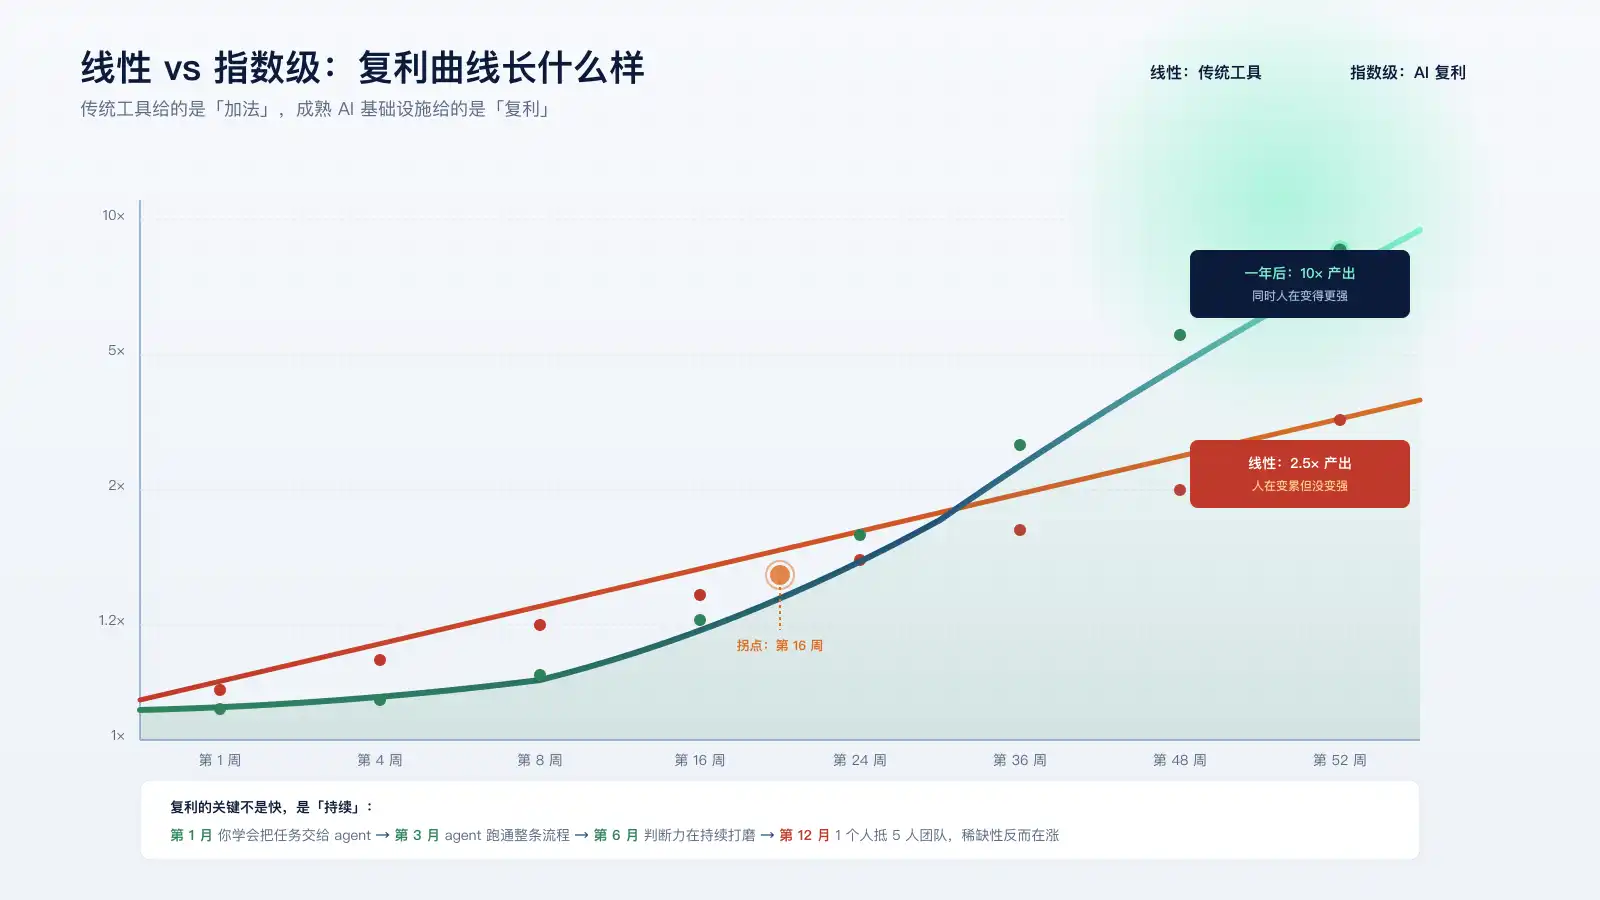
更关键的是——这条曲线是复利式的,不是阶梯式的:
- 第 1 个月:你学会了把任务交给 agent,每周三件小事变快了
- 第 3 个月:agent 替你跑通了整条流程,你的时间被释放出来做思考
- 第 6 个月:你的判断力和品味在持续打磨,反而比纯写代码的同事更值钱
- 第 12 个月:你一个人的产出,抵得上一个 5 人小团队——而你的稀缺性反而在涨
复利的本质不是"快",是"持续"。agent 把「持续」这件事的成本降到接近零,剩下的人和人之间的差距,会被指数级放大。
三、行业这层,哪些岗位会被重新洗牌
我不想空谈"颠覆"。我说几个我自己判断下来「会变化」和「会更值钱」的具体方向。
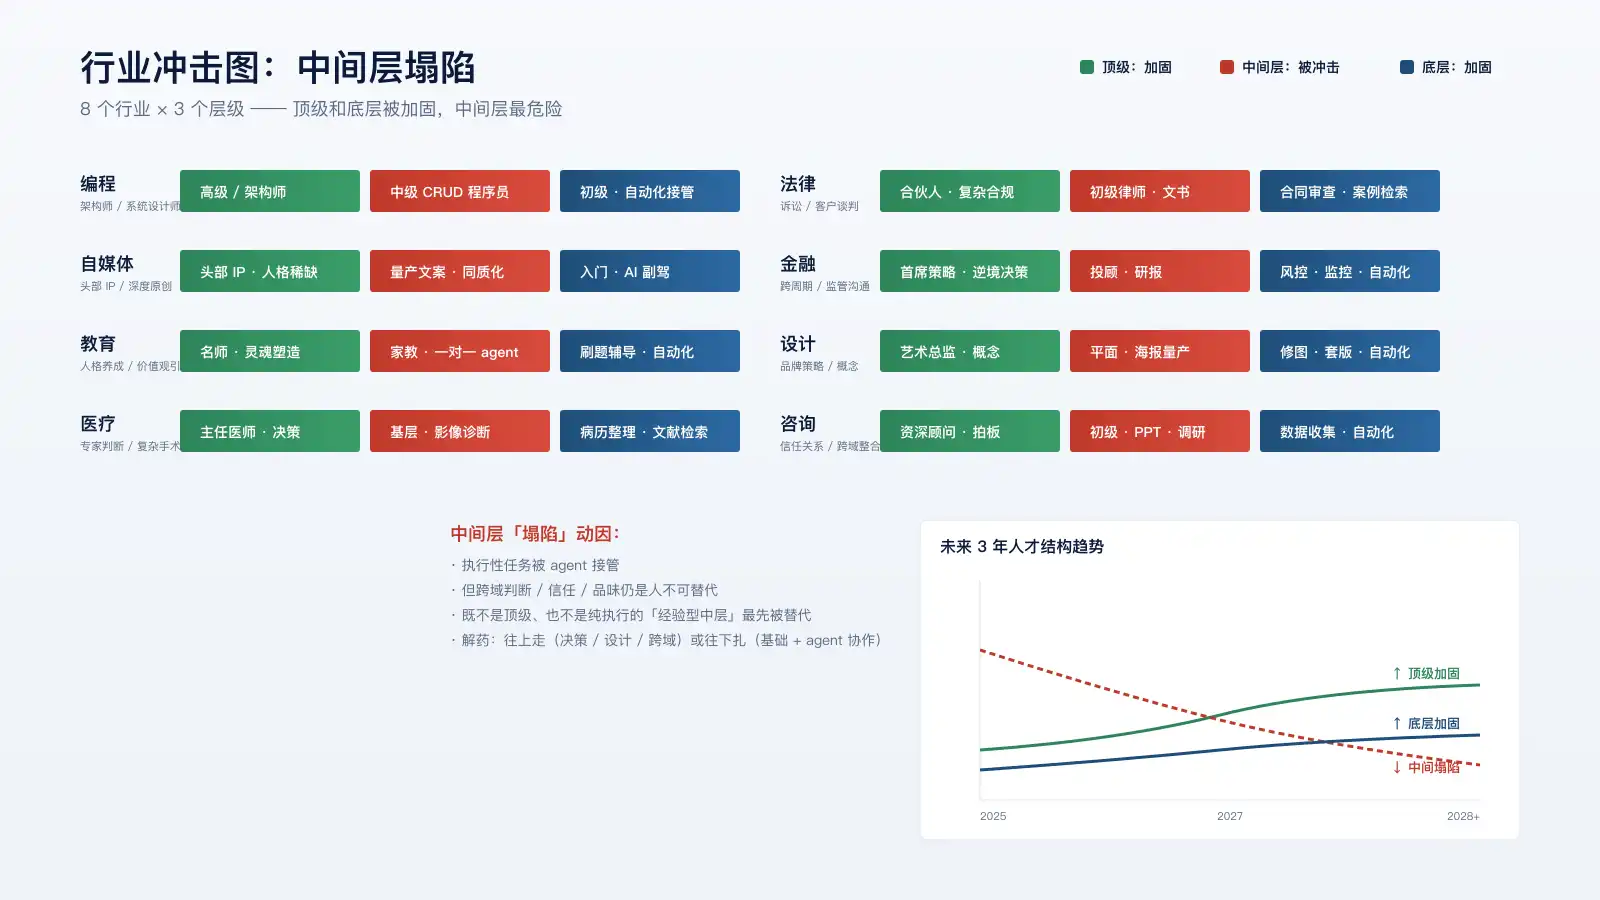
编程这一行,会变得最快。我自己写代码,我对这件事最敏感。初级程序员最危险——他们过去干的活(CRUD、bug 修复、单元测试、写文档),正好是 agent 最擅长的。中级程序员要么往上走,要么被淘汰。高级程序员的价值,从"写出多优雅的代码"变成"设计出让一群 agent 能协作的系统"。代码本身在贬值,但代码的可读性、可审计性、可维护性会变成稀缺品——因为 agent 跑得越快,留下的"需要人看懂"的代码就越多。
自媒体这一行,表面最繁荣,内核最撕裂。内容生产成本会降到接近零,产能不是问题;分发、注意力、人格辨识度才是问题。未来一段时间,"AI 味儿"会变成贬义词,平台反 AI 检测会越来越严。真正的稀缺品是真实经历、独特观点、持续人格——这些 agent 学不走。纯靠 agent 量产内容的人,会越来越像"内容工厂的工人"。
教育、医疗、法律、金融、设计、客服、咨询——这七个行业我都仔细想了一遍,结论几乎一致:「中间层」塌陷,顶级和底层都被加固。中级文案、中级分析师、中级客服、中级运营——既不是顶级专家、也不是纯执行者的"有点经验但可以被替代"的人,会最先感受到挤压。而真正稀缺的,反而是跨领域能力——懂法律的产品经理、懂编程的医生、懂设计的内容创作者。
我把这几个行业的判断浓缩成一句话:未来 3 年,"懂行业 + 会用 AI"的人,会成为新的整合者;纯单一技能的人,会被 agent 一波一波替换。
四、落到我自己身上,我会怎么用
这一段是我最想写的。我不想只当观察者,我想给自己一个能跑起来的方案。
我是程序员,自媒体是副业,但内容生产也是我的主战场。这两件事的 agent 化路径不一样,我想分开说。
程序员的用法:从「做事」切到「设计事」
我手头现在有三个项目:一个公司内部的数据处理平台,一个自己的开源项目(一个跑步数据可视化工具),还有一个是公众号的自动化脚本。
这三个项目,我打算这么用 agent:
- 数据处理平台:让它自己写 ETL、自己跑测试、自己出报告,我只看异常和方向性的判断。预期一周能省 6-8 小时。
- 开源项目:让它做 issue 分类、做 PR 评审、做 changelog 生成。社区互动我还是要亲自做——因为开源的核心是人和人之间的信任,这是 agent 替代不了的。
- 公众号自动化脚本:让它接管多平台分发、评论筛选、定期数据复盘。写作本身我不让 agent 碰——这一点我后面会说为什么。
自媒体的用法:把 agent 当团队,不用它当作者
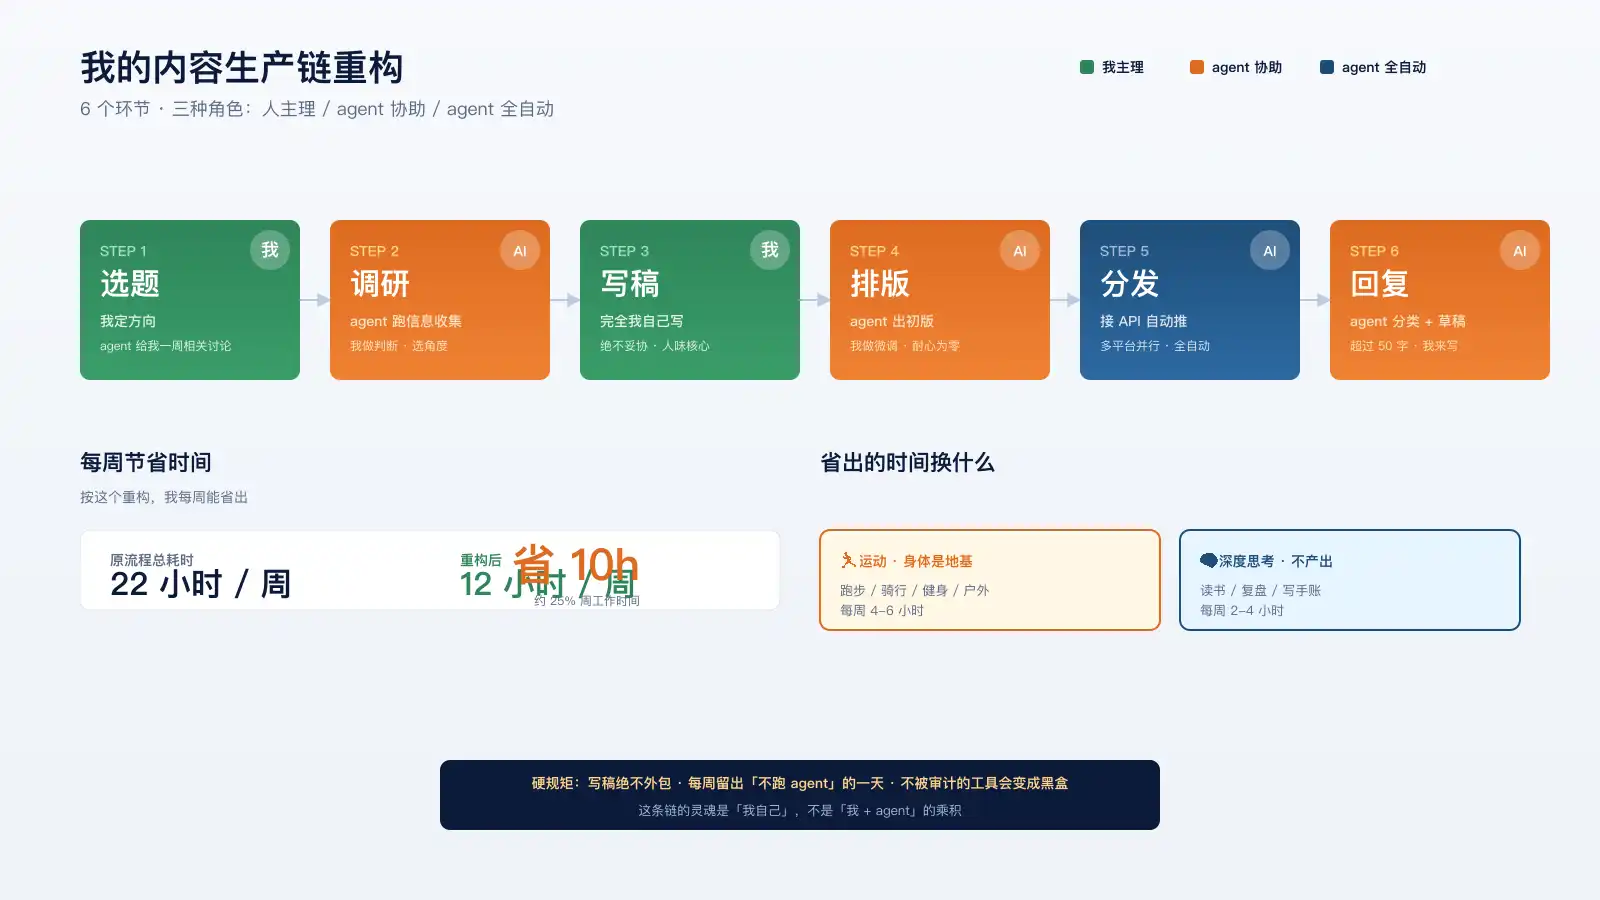
我过去的内容生产链是:选题 → 调研 → 写稿 → 排版 → 多平台分发 → 评论回复。现在我打算把这条链重构成:
- 选题阶段:我定选题,agent 给我做"过去一周这个话题的相关讨论、潜在角度、未被覆盖的点"。
- 调研阶段:agent 帮我跑信息收集、初步整理、交叉验证。我做的是判断哪条信息值得用、哪个角度有话说。
- 写稿阶段:完全是我自己写。这一点我绝不妥协。原因不是"AI 写得不好",是"我需要保持和读者之间那种真实的人味"——读者来看我,是因为我是「猫咪不吃愚」,不是「那个会调 prompt 的人」。
- 排版和配图:让 agent 出初版,我做微调。这一块我的耐心为零,能外包就外包。
- 多平台分发:全自动,agent 接 API 直接推。
- 评论回复:agent 先做分类和草稿,超过 50 个字的回复我自己写。
我自己的算账
每周节省时间:8-10 小时
省出来的时间用来:
- 运动 4-6 小时(健康是地基)
- 深度思考 2-4 小时(读书 + 复盘 + 不产出)
一年下来是 400-500 小时——相当于多出了 12 周的完整工作时间。这部分时间我不用它再生产,而是用来让自己更值钱的那些事情:身体、品味、判断、思考。
五、几条我给自己立的硬规矩
agent 多了之后,最容易出的问题不是"用得不够",是"用得太随意"。我给自己立了几条硬规矩,写下来防止自己以后打脸。
规矩的核心只有一句:让 agent 放大你,不要让 agent 替代你。
第一,不让 agent 替我做判断,只让它替我跑流程。判断"这个选题要不要写"、"这段话该不该删"、"这个观点会不会得罪人"——这些事我亲自做。让 agent 跑数据、跑格式、跑分发,人不应该把「决定权」外包出去。
第二,不让 agent 替我维护人设。我公众号的人设是"程序员 + 运动爱好者 + 真实表达"。这件事 agent 学不走——因为它的学习数据是我过去写的所有文章,但它没有我的真实经历、我的疲惫、我的思考路径。一旦我让 agent 写"看起来像我"的文字,我的人设就开始塌方。
第三,每周留出"不跑 agent"的时间。我会固定一天完全不用 AI——这一天的任务是读书、跑步、和真实的人聊天。agent 不会让我变得更强,但它会让我变得更快;如果我不刻意留出"慢下来"的时间,我会被"快"拖垮。
第四,对自己的核心能力保持练习。我是个程序员,我必须保持写代码的能力——不能让 agent 把我的编程肌肉萎缩掉。运动也一样——我不能因为 AI 让我效率变高,就放弃锻炼自己的身体。这两件事是地基,地基不能外包。
第五,定期审计 agent 的产出。每周我抽 1 小时,回看 agent 跑过的所有任务,找出"它做错的"、"它做过的"、"它浪费的"。这个习惯能让我知道 agent 真的帮了我多少、帮错了多少。不被审计的工具,最容易变成黑盒——而黑盒最危险。
写在最后
我把这次的更新反复想了三遍,最后落到一句话上——
OpenAI 把基础设施给我们建好了,但这不意味着我们能躺平。它意味着"会建基础设施"这件事不再值钱,值钱的是"知道怎么用它解决真问题"。
AI 公司把跑道铺好了,不代表每架飞机都能起飞。真正能起飞的,是那些知道要去哪里、知道怎么飞、知道什么时候该降落的人。
而这次的真正不同——是它第一次给到了「复利」级别的基础设施。以前我们用 AI,是加法;这次以后用 AI,是乘法。区别不在工具本身,区别在你会不会让这架飞机持续飞。
我打算做的事很简单:把 agent 用在我能外包的所有流程上,把时间换回来做只有我能做的事——判断、设计、运动、和真实的人打交道。这不是"用 AI 取代我",是"用 AI 让我更像我自己"。
你呢?你看完这波更新之后,最想用 agent 帮你做什么?又最不想让它碰你哪一块?
评论区聊聊,我想看看大家是怎么把 agent 落到自己手上的——也想看看,谁已经跑出了第一条「复利曲线」。